AI Gateway
운영 중24개 프로젝트의 LLM 호출을 한 곳으로 — Cloudflare 에지 + 무료 VM 위의 LiteLLM·Langfuse
- 기간
- 2026-08 ~ 현재
- 커밋
- 45
- 모델 배포
- 63개
- 프로젝트 키
- 17개
- 추가 인프라 비용
- 0원
기술 스택
- Cloudflare Workers
- TypeScript
개요
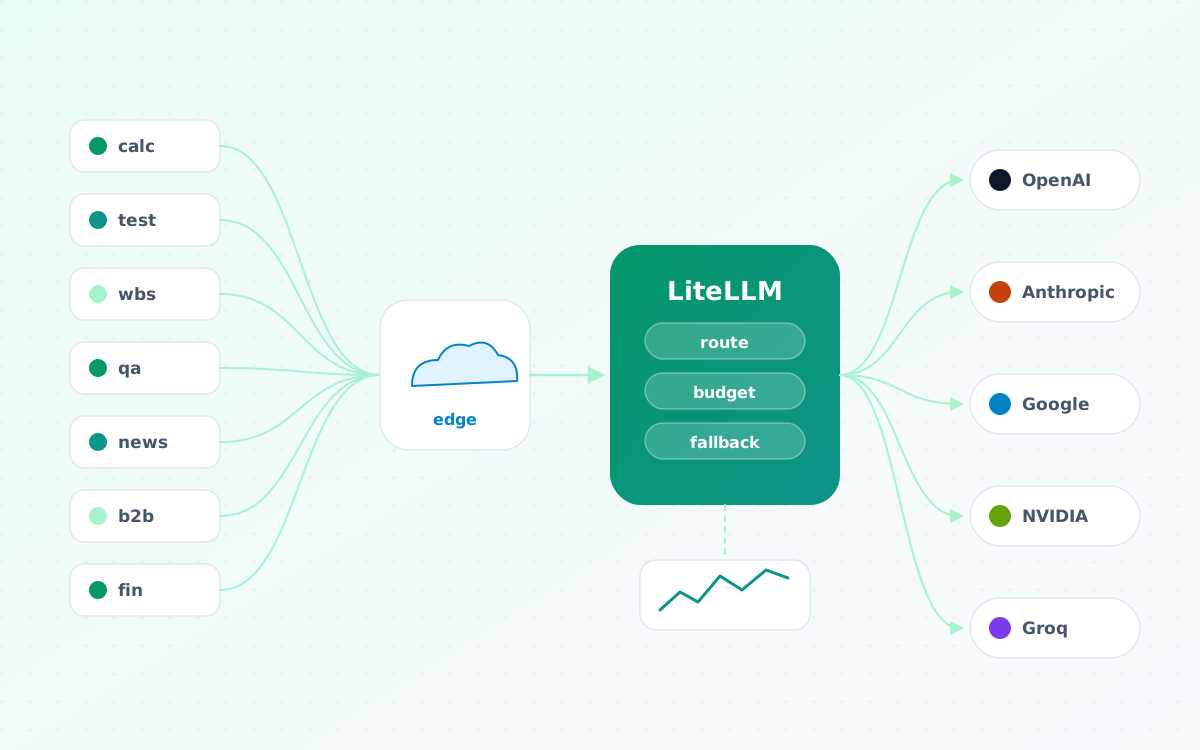
무엇이고 누구를 위한 것인가여러 프로젝트가 쓰는 LLM 호출을 하나의 OpenAI 호환 엔드포인트로 모은 사내 게이트웨이다. 각 프로젝트는 base_url과 키만 바꿔 붙고, 게이트웨이가 모델 라우팅·폴백·가드레일·비용 집계·트레이스 관측을 맡는다.
에지는 Cloudflare Worker가, 데이터플레인은 Oracle Cloud 무료 VM 위의 LiteLLM과 Langfuse가 담당한다. 추가 인프라 비용 없이 운영한다.
문제
무엇이 문제였나LLM을 쓰는 프로젝트가 24개로 늘자 세 가지가 동시에 무너졌다.
키가 흩어졌다. 프로젝트마다 공급사 키를 따로 들고 있어 교체·회수가 어렵고, 어느 키가 어디서 쓰이는지 파악이 안 된다.
누가 얼마를 썼는지 모른다. 공급사 청구서는 프로젝트를 모른다. 게다가 회사 업무용 프로젝트와 개인 프로젝트가 같은 키를 쓰면 지출을 나눌 방법이 없다.
무료 모델을 활용할 수 없다. 무료 티어 모델은 한도가 작고 자주 끊긴다. 프로젝트마다 폴백 로직을 짜는 건 반복 작업이다.
그렇다고 중앙 게이트웨이 서버 하나를 두면 그 서버가 모든 요청의 지연을 결정하고 단일 장애점이 된다.
접근
어떻게 풀었나- 역할을 층으로 나눴다. 요청 수용·인증·캐싱은 Cloudflare 330여 개 POP의 Worker가 사용자 가까이에서 처리한다. 상태가 필요한 라우팅·가드레일·예산 관리는 LiteLLM 데이터플레인 한 곳에 둔다. 에지는 얇게, 정책은 한 곳에.
- 키를 팀에 귀속시켰다. 프로젝트마다 가상 키를 발급하고, 키를 회사·개인 두 팀에 묶었다. 팀마다 30일 상한이 있어, 상한에 닿으면 소속 키가 함께 막힌다. 개별 키 예산과 팀 예산 중 먼저 닿는 쪽이 적용된다.
- 무료 모델을 풀로 묶었다. 여러 무료 공급사의 모델을 하나의 이름 아래 묶고, 하나가 막히면 다음으로 넘어가게 했다.
- 전환을 난이도별로 진행했다. 24개 프로젝트를 설정만 바꾸면 되는 것(5), SDK 초기화만 고치면 되는 것(9), 구조를 고쳐야 하는 것(3), 보류(7)로 나눠 쉬운 것부터 옮겼다.
주요 기능
사용자가 실제로 쓰는 것- OpenAI 호환 API — 프로젝트는
base_url과 키만 교체 - 모델 라우팅·폴백 — 등록 배포 63개, 공급사 장애 시 자동 전환
- 무료 모델 풀 — NVIDIA NIM·Groq 등 무료 모델을 스크리닝 후 풀로 운영, Cloudflare 예비 폴백
- 팀·키 예산 — 회사·개인 팀별 30일 상한, 키별 예산·분당 요청 제한
- 가드레일 — 차단 이벤트 계측
- 비용 집계 — 요청별 지출 로그와 일별 지출 테이블, 비용 API가 없는 공급사 사용량까지
- 관측 — Langfuse 트레이스 대시보드(langfuse.azclab.com)
- 관리 콘솔 — LiteLLM Admin UI(litellm-admin.azclab.com)
아키텍처
어떻게 구성돼 있나 프로젝트 24개 ── OpenAI 호환 호출 (프로젝트별 가상 키)
│ HTTPS
Cloudflare Worker (에지, 330+ POP) ── ai-gateway.azclab.com
클라이언트 인증 · CORS · 에지 캐싱
│
Oracle Cloud Always Free VM (ARM64, 4 OCPU / 24 GB) — docker compose
├─ LiteLLM litellm-admin 라우팅·폴백·가드레일·팀/키 예산
├─ Langfuse Web langfuse 트레이스 대시보드
├─ Langfuse Worker 비동기 트레이스 처리
├─ Postgres × 2 LiteLLM용 / Langfuse용
├─ Redis × 2 Langfuse 큐 / LLM 캐시
├─ ClickHouse 트레이스 저장
└─ MinIO S3 호환 스토리지
│
공급사: OpenAI · Anthropic · Google · NVIDIA NIM · Groq · Qwen …기술적 의사결정
무엇을 고르고 무엇을 버렸나- 회사 지출과 개인 지출을 키 수준에서 갈랐다. 회사 업무 프로젝트는 회사 팀 키만, 개인 프로젝트는 개인 팀 키만 쓴다. 같은 대시보드 안에서도 지출이 섞이지 않고, 한쪽 상한이 다른 쪽을 막지 않는다. 용도가 다른 기능은 같은 프로젝트라도 키를 분리했다 — 배치용 키와 대시보드 챗봇용 키를 따로 두는 식이다.
- 무료 모델은 실측해서 풀에 넣었다. 무료 모델을 일괄 등록하지 않고 스크리닝을 거쳐 통과한 것만 넣었다. 풀 적합성을 실측한 뒤 문제가 있는 배포 3종을 빼서 무료 풀을 7개 배포로 정리했다.
- 관리형 서비스 대신 무료 VM에 자체 호스팅했다. 첫 설계는 Cloudflare Containers와 외부 서버리스 서비스(Neon 0.5GB, Upstash 일 1만 명령, Langfuse Cloud 월 5만 관측)의 무료 한도 안에서 도는 구조였다. 이후 Oracle Cloud의 Always Free ARM VM에 9개 컨테이너 전체 스택을 docker compose로 옮겼다. 외부 서비스의 무료 한도에 묶이지 않는 대신 운영 부담을 직접 진다 — 그 대가가 실제로 청구됐다(아래 배운 점).
- 보존 기간을 데이터마다 다르게 잡았다. 요청별 지출 로그는 90일 뒤 자동 삭제하되, 청구 근거인 일별 지출 집계는 별도 테이블로 남긴다. ClickHouse의 조사용 로그는 7일만 보존한다.
- 에지 캐싱은 Worker에서. 같은 요청은 데이터플레인까지 가지 않고 에지에서 끝난다.
결과
무엇이 달라졌나24개 LLM 사용 프로젝트 중 다수가 게이트웨이를 경유하며, 회사·개인 두 팀으로 17개 프로젝트 키가 운영 중이다.
- 모델 배포 63개를 하나의 엔드포인트 뒤에 두고, 무료 풀이 막히면 자동으로 다음 공급사로 넘어간다.
- 이 게이트웨이의 지출 로그가 비용 추적 대시보드의 입력으로 쓰인다 — 비용 API가 없는 공급사(NVIDIA NIM)의 사용량은 이 로그가 유일한 근거다.
- 추가 인프라 비용은 0원이다(Oracle Always Free VM + 기존 Cloudflare Workers 요금제).
- 루트 경로는 404다. 라우트를 두지 않은 것이며
/v1/models는 401로 정상 응답한다.
배운 점
다시 한다면디스크가 가득 차 Langfuse가 500을 내기 시작했고, 그 사이 20개 프로젝트의 트레이스가 유실됐다. 범인은 사용자 데이터가 아니었다. ClickHouse 시스템 DB가 2.99GiB였는데 Langfuse 실데이터는 38MiB — 79 대 1로, 관측 도구가 자기 자신을 관측하느라 디스크를 채웠다. 디스크 100% → MinIO 쓰기 거부 → Langfuse 500으로 이어졌다. 내부 디버깅 로그 8종을 끄고 조사용 로그는 7일 TTL로 묶어 시스템 DB를 약 80MiB에서 포화하게 만들었고, 정비 스크립트와 부트 볼륨 확장으로 재발을 막았다. 자체 호스팅을 택한 순간부터 "무엇이 쌓이는가"를 아는 것이 운영의 일부가 됐다.