LLM COMPASS
운영 중모델 스펙·비용·벤치마크 비교부터 API vs 셀프호스팅 TCO, 매일 8건의 AI 트렌드 리포트까지
- 기간
- 2026-07 ~ 현재
- 커밋
- 285
- 수록 모델
- 608개
- 프로바이더
- 61곳
- 일일 리포트
- 8건
- 지원 언어
- 4개
기술 스택
- FastAPI
- Playwright
- Pydantic
- Python
- React
- SQLAlchemy
- Tailwind CSS
- TypeScript
- Uvicorn
- httpx
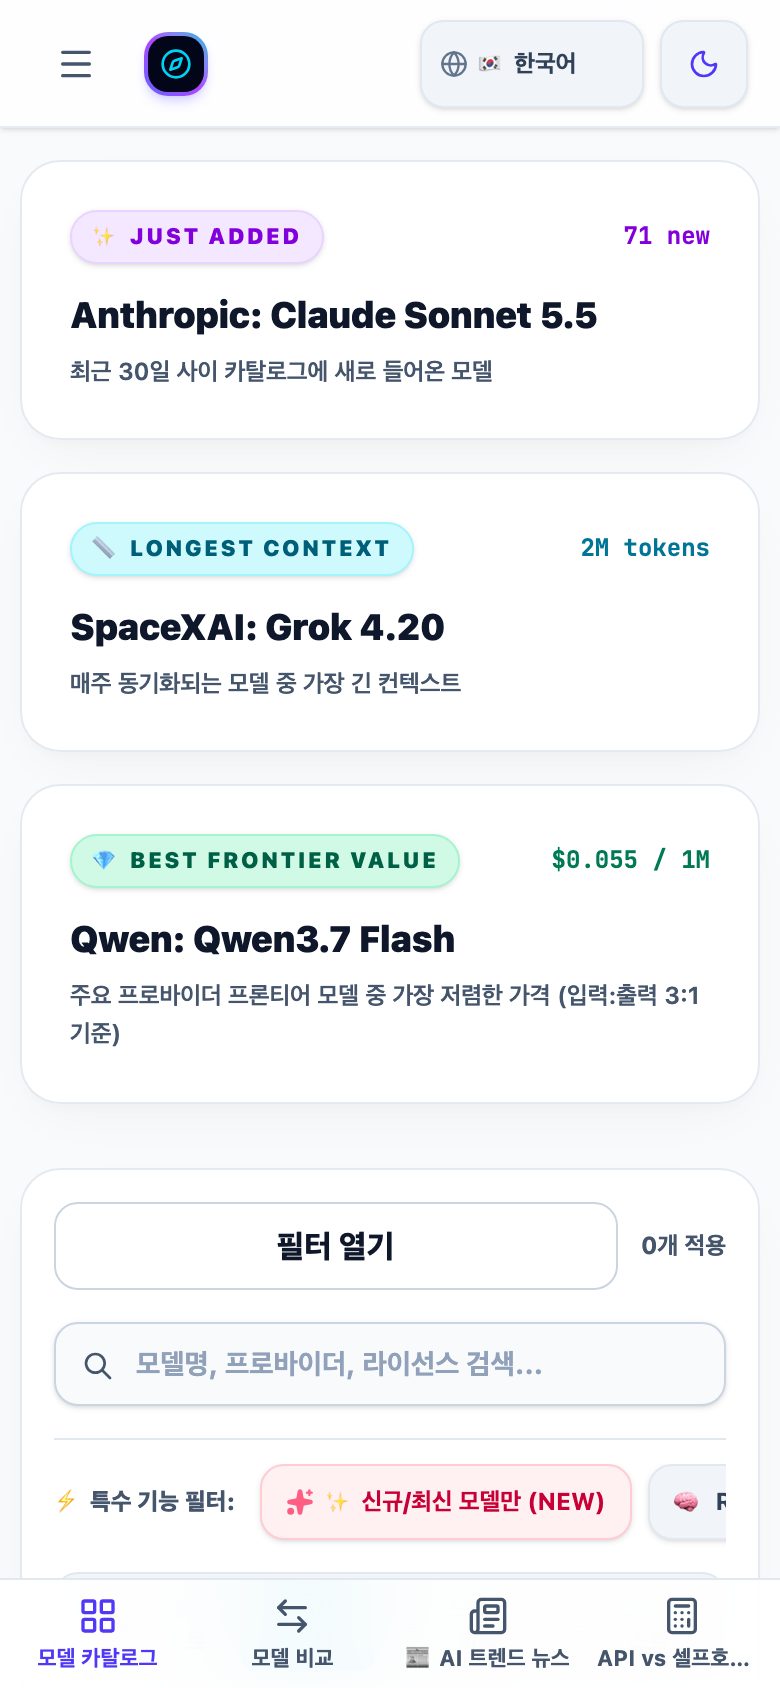
실제 화면 운영 중인 서비스를 그대로 캡처했습니다
2026-10-06 기준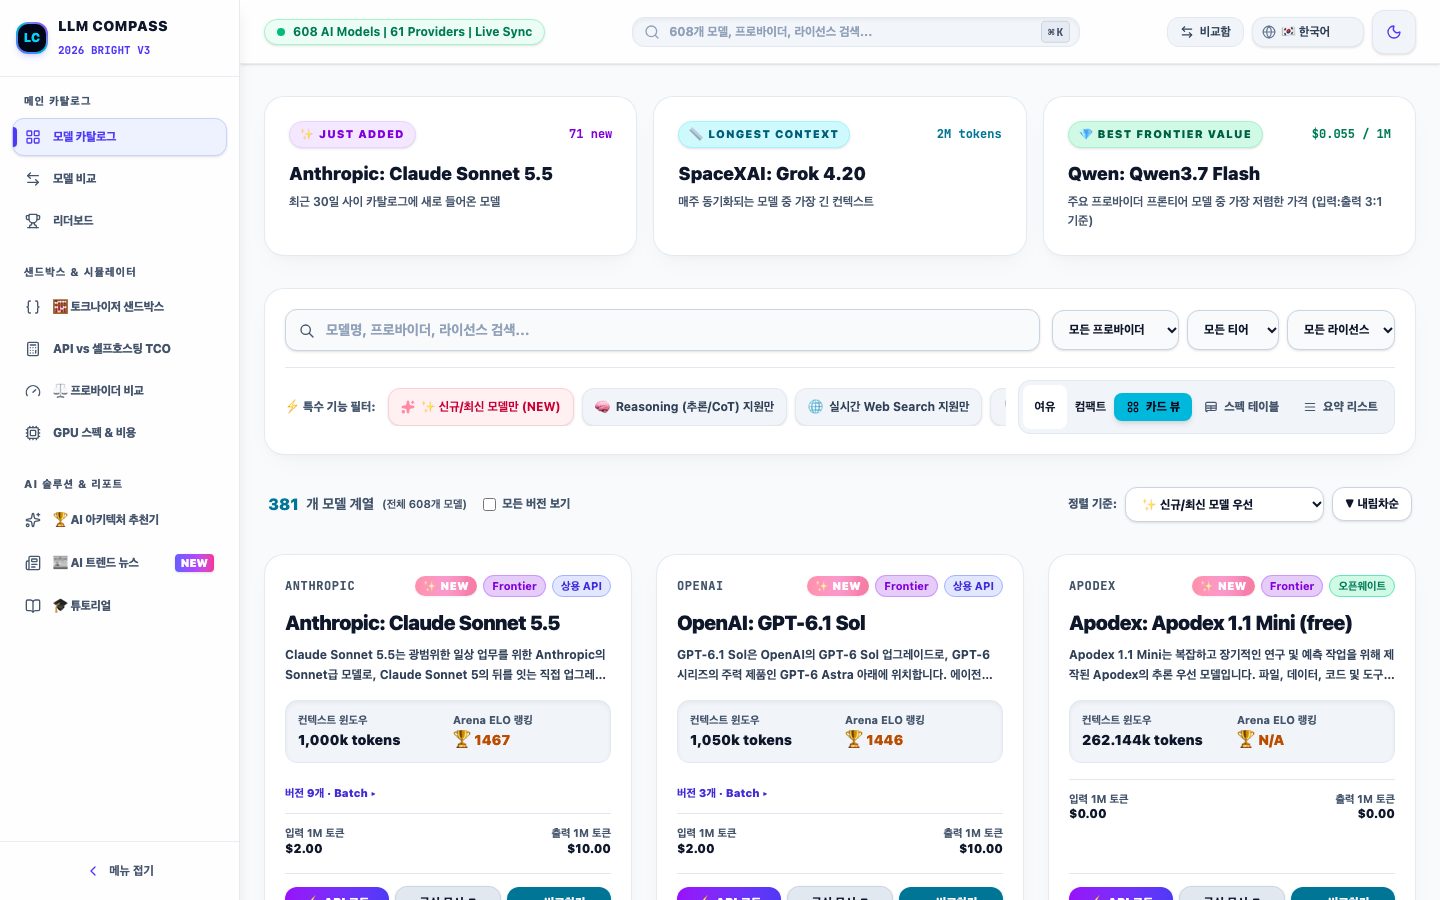
개요
무엇이고 누구를 위한 것인가AI 모델을 고르는 사람을 위한 정보·의사결정 플랫폼이다. 주요 LLM의 스펙·토큰 단가·쿼터·벤치마크를 한 화면에서 비교하고, "API로 쓸지 GPU를 빌려 직접 띄울지"를 총소유비용(TCO)으로 계산해 준다.
여기에 매일 아침 국내외 AI 소식을 묶어 직무별로 읽을 수 있는 트렌드 리포트를 발행한다. 한국어·영어·일본어·중국어 4개 언어를 지원한다.
문제
무엇이 문제였나모델을 고를 때 필요한 정보가 전부 다른 곳에 있다. 스펙과 단가는 공급사마다 표기가 다르고, 벤치마크는 또 다른 곳에 있으며, 같은 축에 놓고 비교하려면 매번 손으로 표를 만들어야 한다.
"API냐 셀프호스팅이냐"는 단가로 답이 안 나온다. 월 토큰량, 피크 요청 수, GPU 종류, 가동률까지 묶어야 손익분기가 나오는데, 그걸 같은 기준으로 계산해 주는 곳이 없었다.
AI 소식은 너무 많고 너무 빨리 낡는다. 하루에도 수십 건이 쏟아지고, 같은 사건을 여러 매체가 제각각 다룬다. 다 읽을 수 없고, 읽어도 "그래서 내 일에 뭘 해야 하나"가 남는다.
접근
어떻게 풀었나- 스펙·비용·벤치마크를 한 데이터 모델로 정규화했다. 공급사마다 다른 표기를 같은 필드(입력·출력·캐시 토큰 단가, RPM·TPM·RPD 쿼터, Arena ELO·MMLU-Pro·SWE-bench, 권장 GPU)로 맞춰야 비교가 성립한다.
- TCO를 같은 입력으로 계산한다. 월간 토큰량·피크 요청 수를 넣으면 상용 API 비용과 클라우드 GPU(H100·A100·L40S) 셀프호스팅 비용을 함께 산출하고, API 쿼터를 돌파하는 시점과 손익분기점을 보여준다.
- 뉴스는 "기사"가 아니라 "사건" 단위로 묶었다. 매일 RSS로 모은 기사를 클러스터링해, 여러 매체가 다룬 같은 사건을 하나의 리포트로 만든다. 하루 발행량은 8건으로 고정했다.
- 읽는 사람별로 렌즈를 달았다. 개발자·기획/PM·비즈니스·연구 네 직무 필터를 두고, 3줄 요약 외에 "현업에서 어떻게 활용하거나 대비할지"를 직무별로 뽑는다.
주요 기능
사용자가 실제로 쓰는 것- 모델 카탈로그 — 프로바이더·티어(Frontier·Mid·Small·Micro)·오픈웨이트 필터, 토큰 단가·쿼터·벤치마크·권장 GPU
- 모델별 API 코드 — Python SDK·Node.js·cURL·LangChain 네 형식의 호출 스니펫을 카드에서 바로 복사
- 다자간 비교 — 여러 모델의 비용·컨텍스트 윈도우·코딩 성능·가성비를 표와 카드로 비교
- TCO 시뮬레이터 — API 대 셀프호스팅 총비용, 쿼터 돌파 시점, 손익분기점
- 아키텍처 어드바이저 — 챗봇·RAG·에이전트 코딩·대용량 문서 분석 등 검증된 시나리오 프리셋과 맞춤 아키텍처 명세서 생성
- AI 뉴스 펄스 — 매일 8건의 사건 단위 리포트, 직무별 렌즈, 실전 활용 팁, 대표 썸네일
- 튜토리얼 — AI 코딩 도구 10종 가이드와 실무 스킬 스니펫
- 리더보드·GPU 사양 — 벤치마크 랭킹과 주요 AI GPU의 VRAM 스펙
아키텍처
어떻게 구성돼 있나 React 19 + Vite — 정적 자산
│ same-origin
Cloudflare Worker (src/worker.ts) ── llmcompass.azclab.com
├─ 모델·뉴스 조회 API
├─ TCO 계산 · 아키텍처 추천 API
└─ 정적 자산 서빙
│
Cloudflare D1 (llm-compass-db)
▲
GitHub Actions — Python 배치 (매일 아침)
RSS 23곳 수집 → 본문 추출 → 중복 제거 → 사건 클러스터링(최대 8)
→ LiteLLM 게이트웨이(gpt-4o-mini) 생성 → 결정론적 품질 검증 → D1 저장운영 트래픽의 진입점은 Cloudflare Worker 하나다. 초기의 FastAPI 백엔드는 로컬·레거시 호환용으로만 남겼다. 뉴스 생성은 공개 API가 아니라 배치에서만 일어난다 — 누구나 부를 수 있는 엔드포인트에 LLM 생성을 열어 두지 않는다.
기술적 의사결정
무엇을 고르고 무엇을 버렸나- 운영 진입점을 Worker 하나로 줄였다. 처음엔 FastAPI 서버가 API를 맡았지만, 조회와 계산은 서버 상태가 필요 없어 Worker + D1로 옮겼다. 상시 서버가 사라지고 프런트엔드와 같은 출처에서 서빙된다.
- LLM 생성을 배치로 격리했다. 리포트 생성은 GitHub Actions에서만 돌고, 사용자 요청 경로에는 LLM 호출이 없다. 비용이 트래픽이 아니라 하루 8건에 고정되고, 생성이 실패해도 사이트는 전날 리포트를 그대로 보여준다.
- 생성 결과를 결정론적으로 검증한다. LLM이 만든 리포트는 필수 필드(제목·주제·요약·본문·태그) 검사, AI 관련성 검사, 출처·리포트 중복 검사를 통과해야 저장된다. 모델에게 "잘 써 달라"고 부탁하는 대신 코드가 거른다.
- 피드는 실측해서 넣고 실측해서 뺀다. RSS 파싱과 본문 추출이 둘 다 성공하는 것만 소스로 추가했다. 마이크로소프트 블로그는 피드가 410 Gone으로 사라져 매일 0건이라 뺐다. 반대로 스크래핑을 막는 곳(429·403)은 지금은 기여가 없어도 차단이 풀리면 자동으로 다시 잡히도록 남겼다.
- 소스를 늘려도 발행량은 늘리지 않았다. 하루 8건은 클러스터 상한이 정한다. 소스를 추가하는 목적은 양이 아니라 같은 사건을 여러 매체가 다룬 클러스터를 더 잘 만드는 것이다.
결과
무엇이 달라졌나llmcompass.azclab.com에서 운영 중이며, 7개 메뉴(카탈로그·비교·TCO·아키텍처·뉴스·튜토리얼·리더보드)를 4개 언어로 제공한다.
- 카탈로그에 모델 608개, 프로바이더 61곳이 수록돼 있다(사이트 표기, 2026-10-06 기준).
- 매일 아침 GitHub Actions 배치가 23개 소스에서 기사를 모아 8건의 사건 단위 리포트를 발행한다.
- 운영이 Worker + D1로 단순해져 상시 백엔드 서버 없이 돈다.
- 커밋 285개, Python 테스트 파일 14개(카탈로그 upsert·벤치마크 동기화·리포트 생성·중복 제거 등).
배운 점
다시 한다면소스를 늘리면 좋은 리포트가 나올 거라는 생각은 반만 맞았다. 목록에 있어도 본문을 못 읽는 피드는 아무것도 기여하지 않았고, 하나는 이미 사라진 피드였다 — 목록에 있다는 것과 기여한다는 것은 다르다. 그래서 피드마다 "파싱되는가, 본문이 읽히는가"를 실측한 뒤에만 넣고, 하루 0건인 소스는 정기적으로 걸러낸다. LLM 품질도 같은 방식으로 다뤘다 — 프롬프트를 다듬는 것보다 결과를 코드로 검증하는 쪽이 재현 가능했다.