TestMyLuck
운영 중테스트를 데이터로 정의해 20개 로케일로 굴리는 심리·운세 서비스
- 기간
- 2026-08 ~ 현재
- 커밋
- 480
- 로케일
- 20개
- 정적 페이지
- 173개
- 테스트 정의
- 170개
기술 스택
- Alembic
- Cloudflare Workers
- Drizzle
- FastAPI
- Next.js
- OpenNext
- Pydantic
- Python
- React
- SQLAlchemy
- Sentry
- Tailwind CSS
- TypeScript
- httpx
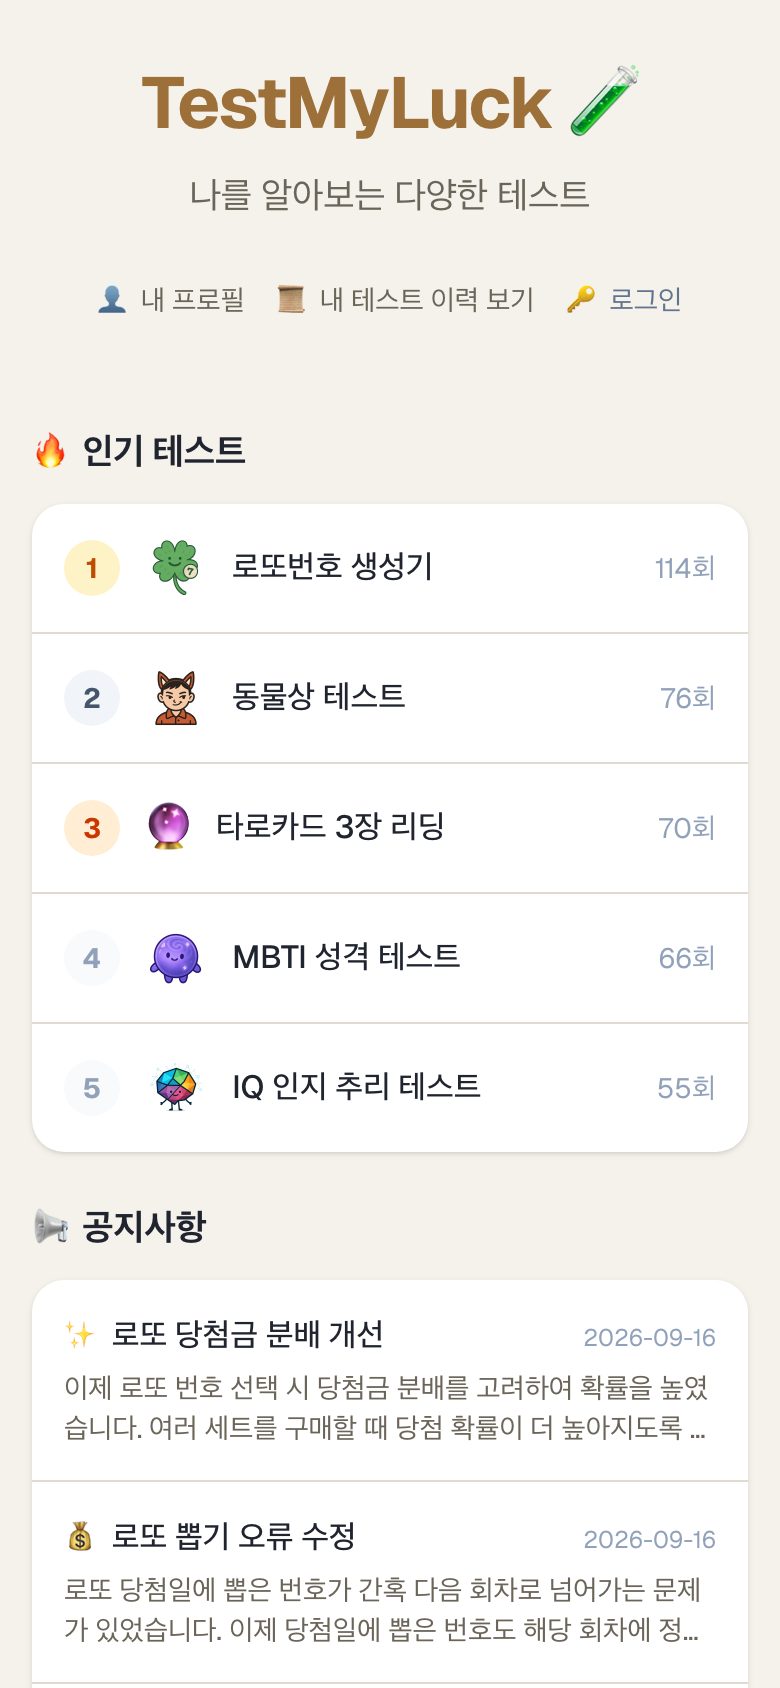
실제 화면 운영 중인 서비스를 그대로 캡처했습니다
2026-10-06 기준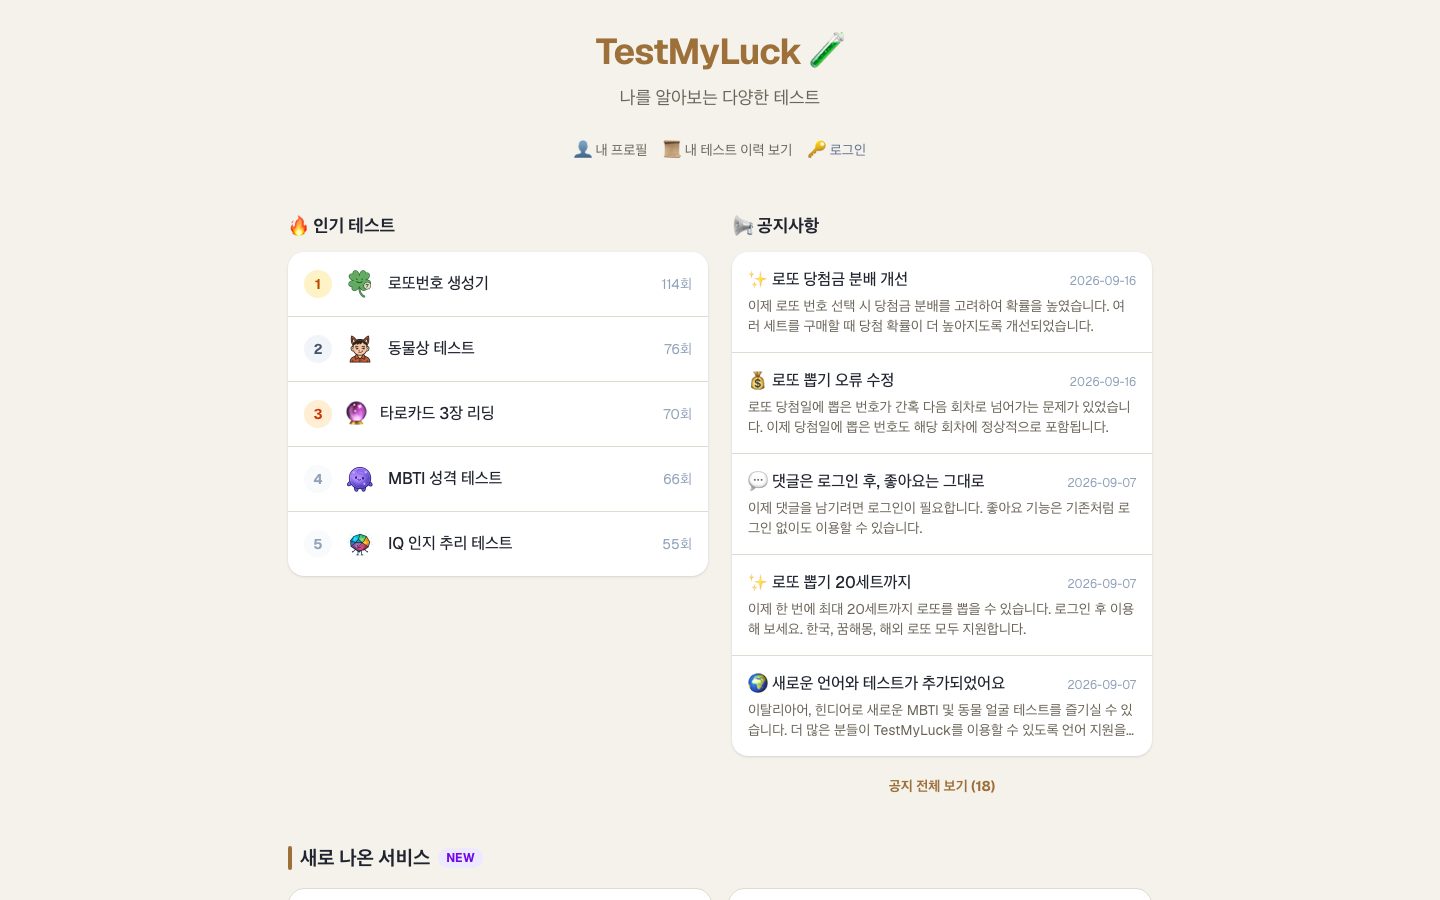
개요
무엇이고 누구를 위한 것인가MBTI·타로·사주·수비학·별자리 운세부터 IQ·EQ, 로또 번호 생성까지 다루는 모바일 우선 테스트·운세 서비스다. 한국형 심리테스트 포맷(짧은 문항, 위트 있는 결과)에 결과 카드 공유를 붙여 바이럴로 유입을 만든다.
한국어를 루트로 20개 로케일을 운영한다. 단순 번역이 아니라 언어권마다 다른 콘텐츠를 낸다 — 힌디·타밀·텔루구권엔 쿤달리 궁합, 중국어권엔 십이지, 일본어권엔 오미쿠지, 스페인어권엔 "타로 Sí o No" 같은 식이다.
문제
무엇이 문제였나이런 서비스를 키우려 할 때 세 군데서 막힌다.
카탈로그가 안 늘어난다. 테스트 한 종을 추가할 때마다 문항 화면·채점 로직·결과 화면을 새로 만들면, 종수 × 로케일 수만큼 유지보수가 불어난다. 20개 로케일이면 그 곱이 금방 감당 불가가 된다.
공유가 끊긴다. 유입은 결과 카드 공유에서 나오는데, 링크를 받은 사람이 자기 브라우저에서 테스트를 다시 풀어 다른 결과를 보면 공유의 의미가 사라진다.
LLM 비용이 통제되지 않는다. 결과 해석을 AI로 풍부하게 만들고 싶지만, 방문 한 건마다 모델을 부르면 트래픽이 늘수록 적자가 된다.
접근
어떻게 풀었나- "테스트 = 콘텐츠" 모델. 각 테스트를 문항·채점 규칙·결과 템플릿을 담은 데이터 파일로 정의하고, 범용
TestRunner하나가 전부를 같은 방식으로 렌더링한다. 새 테스트 추가는 데이터 파일 1개 작성 + 레지스트리 등록으로 끝난다. 로케일별 변형까지 포함해 테스트 정의가 170개지만 화면 코드는 하나다. - 점수는 100% 클라이언트에서, 결정론적으로. 채점은 순수 계산이라 서버도 모델도 필요 없다. LLM은 결과 해석이라는 선택적 레이어에만 쓴다.
- 해석 캐시 키를 결과 유형으로 잡았다. 테스트·결과 유형·프로필 해시·로케일 단위로 캐싱해, 같은 유형이 나온 사용자끼리 해석을 공유한다. 비용이 방문 수가 아니라 결과 유형 수에 비례한다.
- 공유는 저장된 결과를 연다. 결과를 D1에 저장하고
share_token으로 조회하므로, 공유받은 사람은 테스트를 다시 푸는 게 아니라 원본과 똑같은 화면을 본다.
주요 기능
사용자가 실제로 쓰는 것- 테스트 카테고리 — 성격·심리, 인지(IQ), 감성(EQ), 운세(서양 별자리·베다 점성술·사주), 연애·궁합, 커리어, 밈
- 언어권별 전통 콘텐츠 — 쿤달리 궁합(hi·ta·te), 十二生肖(zh), 오미쿠지(ja), 수비학(de), 타로 3장 리딩(en·fr·ru), 타로 Sí o No(es)
- 결과 공유 — 인스타 스토리 비율(9:16) 결과 카드 다운로드, 카카오톡 공유, 결과별 동적 OG 이미지
- AI 심층 분석 — 결과 유형에 대한 LLM 해석. 섹션 단위 카드로 구조화해 표시
- 인기 순위·내 이력 — 플레이 수 기반 랭킹, localStorage 기반 이력(로그인 불필요)
- 마음 자가검진(비공개 시험 운영) — PHQ-9·GAD-7·ASRS·WHO-5. 테스트와 완전히 분리된 별도 모듈
아키텍처
어떻게 구성돼 있나 20개 로케일 × (진입 + 결과) = 173개 페이지 ── 전부 SSG (빌드 시 생성)
│
Cloudflare Workers (OpenNext) ── testmyluck.com
├─ R2 incremental cache 키 {buildId}/{hash}, 1시간 재검증
├─ D1 (Drizzle) 결과·share_token·플레이 수
└─ /api/ai/interpret LLM 해석 — slug·유형·프로필·로케일 단위 캐시
Browser — 채점·운세 계산 100% 클라이언트서버는 "빈 껍데기"만 렌더하고 실제 계산은 전부 브라우저에서 한다. 이 원칙 덕분에 페이지 캐싱 정책을 서비스마다 다르게 가져갈 필요가 없다. 프런트엔드가 자체 D1과 LLM 연동을 갖고 API 라우트를 same-origin으로 통합해 별도 백엔드 없이 단독 배포된다.
기술적 의사결정
무엇을 고르고 무엇을 버렸나- 캐싱 전에 서버 코드부터 전수 감사했다. SSG로 전환하면 "오늘의 운세"가 빌드 날짜로 얼어붙을 위험이 있다. 그래서 서버부
page.tsx·layout.tsx80개 파일을 전수 감사했고, 사용자 입력·DB·오늘 날짜를 읽는 코드가 단 1곳(dateModified메타데이터)뿐임을 확인한 뒤 전 서비스에 같은 정책을 적용했다. - 서비스를 캐싱 리스크로 분류해 검증했다. 문항 기반(MBTI)·결정론적 계산(사주)·날짜 의존(오늘의 운세·호로스코프)·실시간 데이터(로또)·랜덤(타로) 다섯 유형으로 나눠, 특히 날짜 의존과 실시간 유형을 집중 검증했다. 사용자에게 보이는 운세·번호는 브라우저에서 다시 계산돼 영향이 없었다.
- 캐시 무효화를 빌드 ID에 맡겼다. R2 캐시 키에 빌드 ID를 넣어 배포할 때마다 새 네임스페이스가 생긴다. 수동 캐시 퍼지가 필요 없다. 이전 빌드 항목이 고아로 남지만, 무료 티어(월 10GB)를 소진하려면 수천 번 배포해야 해서 지금은 정리하지 않는다.
- 공유 캐시는 "무엇이 같아야 공유해도 되는가"를 테스트 유형별로 정했다. 초기 키에는 로케일이 빠져 있어 같은 점수의 다른 언어 해석이 반환될 수 있었다. 더 심각한 건 손금 사진·이름 궁합처럼 입력마다 결과가 달라지는 생성형 테스트였다 — 결과 코드가 고정값이라 점수가 키에 반영되지 않아, 다른 사람의 AI 해석이 재사용될 수 있었다. 로케일을 키에 추가하고, 생성형 테스트만 점수 전체를 해시에 넣었다. MBTI처럼 아키타입이 정해진 테스트는 공유 캐싱을 유지해 비용 이점을 지켰다.
- 자가검진은 "테스트가 아니다"로 설계했다. 우울·불안 척도 응답은 민감정보라, 테스트 엔진·결과 저장·공유 토큰·AI 해석 경로 어디에도 연결하지 않았다. 브라우저에서 채점하고 저장하지 않는다. 모듈 의존 방향도 한쪽으로 막아 나중에 별도 도메인으로 떼어낼 수 있게 했다.
- 자가검진에 깨지기 쉬운 세 가지를 테스트로 묶었다. PHQ-9 자해 문항은 총점과 무관하게 위기 안내 배너를 띄운다. 모든 페이지는 서버에서 허용 목록으로 접근을 막는다. ASRS·WHO-5는 비상업적 사용만 무료라 척도마다 라이선스 상태(
clearance) 필드를 두고, 서면 허가 없이는 공개하지 않는다.
결과
무엇이 달라졌나20개 로케일에서 운영 중이며, 커밋 480개로 이 저장소군에서 가장 활발하다.
- 173개 페이지를 전부 정적 생성하고, 사용자별 계산은 클라이언트가 맡아 페이지 캐시 하나로 모든 서비스를 덮는다.
- 언어권별 콘텐츠 심화 기획서 35건을 구현하고, 항목마다 타입 체크·린트·실제 브라우저 조작으로 검증했다.
- 캐싱 전환 후 검증에서 발견된 이슈는 1건 — 날짜 의존 페이지의
dateModified메타데이터가 빌드 시점으로 고정되는 것으로, 사용자 콘텐츠가 아닌 검색엔진 신호에 한정됐다. - 단위 테스트 68개.
배운 점
다시 한다면같은 "캐싱 적용"이라도 서비스마다 리스크가 다르다는 걸 분류부터 하고 들어간 게 유효했다. 그 과정에서 거꾸로 "계산은 클라이언트" 원칙이 캐싱 정책을 단순하게 만든다는 걸 확인했다 — 서버가 아는 게 적을수록 캐시가 틀릴 여지도 적다. AI 해석 캐시에서는 공유 캐시의 비용 이점이 그대로 위험이 될 수 있다는 걸 배웠다 — 키에서 무엇이 빠졌는지는 평소엔 안 보이다가, 남의 결과가 내 화면에 나오는 순간에야 드러난다. 자가검진 모듈에서는 반대 방향의 교훈을 얻었다. 기능을 붙이는 것보다 어디에 연결하지 않을지를 정하는 게 더 중요한 설계였다.