blogops
내부 시스템AI 초안을 9개 규칙의 발행 게이트로 거르는 정책 준수형 블로그 운영 플랫폼
- 기간
- 2026-08 ~ 현재
- 커밋
- 33
- 발행 게이트
- 9개 규칙
- 대기 초안
- 12편
- 팩트 레지스트리
- 19건
기술 스택
- FastAPI
- Playwright
- Python
- Uvicorn
- httpx
개요
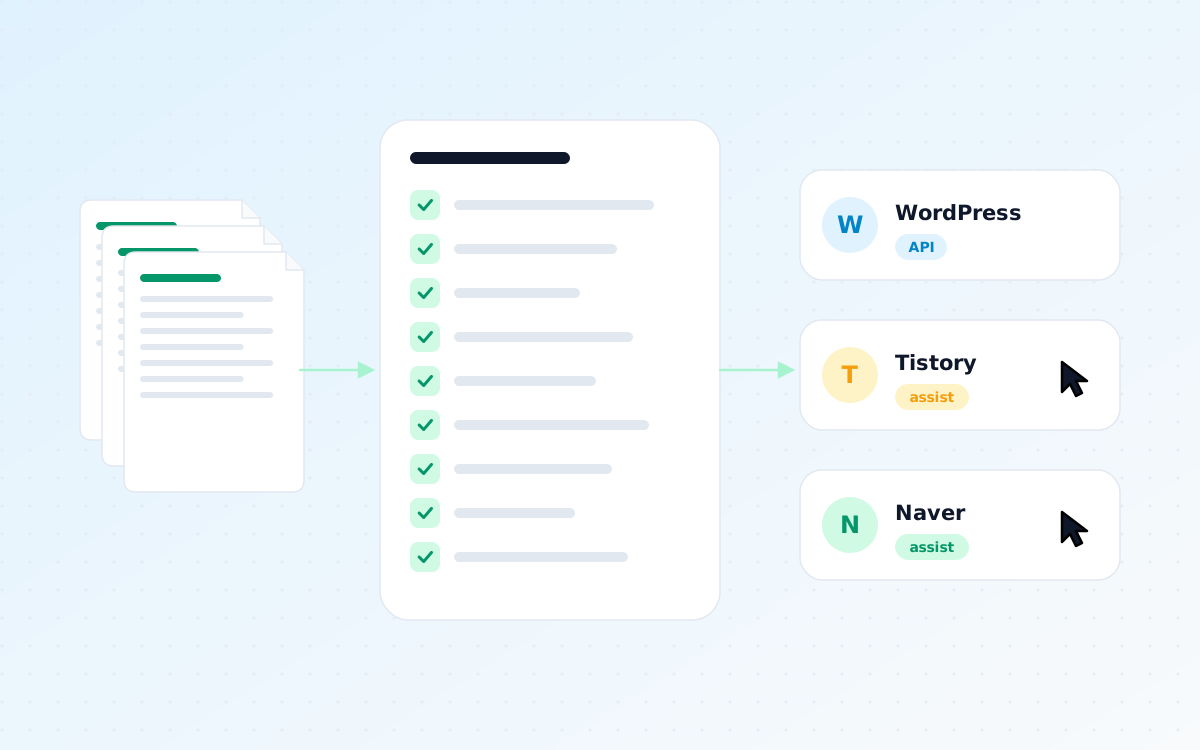
무엇이고 누구를 위한 것인가AI로 쓴 블로그 초안을 국내외 여러 플랫폼에 발행하되, 사람 검수와 규칙 게이트를 통과한 것만 내보내는 운영 플랫폼이다. 초안·팩트·이미지·채널별 변형·발행 일정·성과를 한 곳에서 관리하고, 워드프레스는 API로, API가 닫힌 티스토리·네이버는 브라우저 보조 발행으로 다룬다.
처음엔 블로그 운영 전략 문서와 콘텐츠 디렉터리에서 시작했고, 운영 규칙을 코드로 옮기면서 플랫폼(blogops)이 됐다.
문제
무엇이 문제였나AI로 블로그 글을 대량 생산하면 플랫폼 패널티를 맞는다. 네이버 저품질 판정과 구글의 대량 생성 콘텐츠 정책이 모두 그쪽을 겨냥한다. 반대로 전부 손으로 쓰면 여러 플랫폼을 동시에 굴릴 수 없다.
판이 한 번 더 바뀌었다. 생성형 검색이 늘면서 정보성 글만으로는 유입이 줄어든다. 답을 검색 결과에서 바로 얻으면 클릭이 일어나지 않는다.
그리고 발행 경로 자체가 막혀 있다. 티스토리 Open API는 2024년 2월에, 네이버 블로그 쓰기 API는 2020년 5월에 종료됐다. Medium은 신규 토큰을 멈췄고, X는 링크가 들어간 게시물에 건당 요금을 매긴다. 자동화를 하고 싶어도 "자동으로 올릴 수 없는" 곳이 국내 주력 채널이다.
접근
어떻게 풀었나- 게이트를 하나의 순수 함수로 만들었다.
can_publish(post, channel)이 아홉 가지 규칙을 모두 통과해야 발행 작업이 생긴다. 웹 화면·CLI·스크립트 어느 경로로 발행하든 같은 함수를 지난다. 규칙은 표 기반 테스트로 고정했다. - 수치는 팩트 레지스트리에서만 가져온다. 본문에 숫자를 직접 쓰지 않고 팩트 토큰으로 참조한다. 팩트마다 등급(공식·언론 복수 등)과 유효기간이 있어, 기간이 지나면 해당 글이 재검수 대상으로 돌아간다.
- API가 없는 곳은 "보조 발행"으로. 브라우저에 본문을 자동으로 채워 넣되, 발행 버튼은 사람이 누른다. 로그인 세션은 저장해 재사용한다.
- 정보성 글에 도구를 붙인다. 생성형 검색은 답을 읽고 끝내지만, 계산기 같은 도구는 직접 써야 한다. 글 안에 인라인 계산기 위젯을 넣는다 — 같은 저장소군의 계산기·테스트·게임 서비스가 그 도구 역할을 한다.
주요 기능
사용자가 실제로 쓰는 것- 콘텐츠 상태 머신 — 아이디어 → 초안 → 팩트 확인 → 검토 → 승인 → 예약 → 발행, 팩트 변경·만료 시 재검수 루프
- 발행 게이트 9개 규칙 — 승인 리비전 일치, 미확인 수치 0건, AI 활용·제휴 고지, 경험 신호, 채널 빈도 한도, 채널별 금지 요소, 비-canonical 채널 변형 필수, 대표 이미지 규격, 이미지 alt
- 채널 어댑터 — 워드프레스(REST API), 티스토리·네이버(보조 발행)
- 채널별 변형·canonical — 원문 채널 외에는 제목·본문 변형을 필수로, 중복 콘텐츠 방지
- 팩트 레지스트리 — 등급·출처·유효기간·변경 이력, 만료 점검
- 재배포 — Threads·Telegram·Tumblr
- 성과 수집 — 채널별 성과 CSV 수집과 월별 리포트
- AI 인용 준비도 채점·계정 리스크 경고
- 인라인 위젯 — 퍼센트 계산기(4개 모드)를 본문에 삽입
아키텍처
어떻게 구성돼 있나 blogops (Python, SQLite)
CLI · Web admin · scripts 세 경로 모두 같은 게이트를 지난다
│
▼
gate.can_publish(post, channel) 9개 규칙 — 순수 함수, 표 기반 테스트
│ 통과
▼
publish job ─▶ worker
├─ WordPress REST API (앱 비밀번호)
├─ Tistory 보조 발행 — 자동 입력 후 사람이 클릭
└─ Naver Blog 보조 발행 — 동일
idea → drafting → fact_check → in_review → approved → scheduled → published
▲ │ │
└── rejected ◀┘ refresh_needed ◀────────┘
(팩트 변경·유효기간 만료)
fact registry ─▶ 본문 토큰 치환
redistribute ─▶ Threads · Telegram · Tumblr
metrics CSV ─▶ 월별 리포트
alerts ─▶ Telegram기술적 의사결정
무엇을 고르고 무엇을 버렸나- 티스토리 하루 발행 한도를 2로 잡았다. 플랫폼 한도는 5지만, "하루 수십 건"은 저품질 신호다. 한도의 여유분을 남기고 사람다운 빈도를 기본값으로 뒀다. 같은 채널 연속 발행에는 최소 간격도 둔다.
- 승인 이후 고친 글은 다시 승인받는다. 승인된 리비전과 현재 리비전이 같아야 발행된다. 승인 뒤 한 글자라도 바뀌면 게이트에서 막힌다. 채널별 변형도 승인 이후 수정되면 막힌다.
- 보조 발행의 경계를 "클릭"에 그었다. 자동 로그인은 네이버에서 거의 항상 캡차를 부른다. 그래서 로그인 세션을 한 번 저장해 재사용하고, 본문 입력까지만 자동화한다. 발행 클릭은 사람이 한다 — 플랫폼 정책을 우회하지 않는 선이다.
- 쓰지 않을 API를 명시했다. 구글 인덱싱 API는 채용 공고·방송 이벤트 전용이라 블로그 글에 쓰면 정책 위반이다. 사용 금지로 문서에 박았다. X는 링크 게시가 건당 과금이라 보류했다.
- 대표 이미지에 규격을 걸었다. 구글 디스커버 노출을 위해 폭 1,200px 이상을 게이트 규칙으로 뒀다. 계산기 위젯의 대표 이미지는 위젯을 실제로 렌더한 화면을 캡처해 만든다.
- 설계를 스스로 점검했다. 설계 문서 끝에 "지금 코드에서 확인된 결함"과 "설계 공백"을 따로 적고 반영 순서를 정했다. 비-canonical 변형 필수, 대표 이미지 규격 같은 규칙이 이 점검에서 추가됐다.
결과
무엇이 달라졌나발행 게이트·상태 머신·워드프레스 어댑터·티스토리와 네이버 보조 발행·재배포·성과 수집·AI 인용 채점까지 플랫폼 기능이 갖춰졌다.
- 초안 12편이 팩트 확인·검토 단계에 있고, 검증된 수치 19건이 팩트 레지스트리로 옮겨져 초안 8편이 토큰으로 참조한다.
- 아직 발행된 글은 없다. 게이트를 통과한 글만 나간다는 원칙상, 검수가 끝나야 첫 발행이 이뤄진다.
- 원격 저장소가 없어 로컬에만 존재한다 — 백업이 없는 상태다.
배운 점
다시 한다면자동화를 설계하기 전에 "어디까지 자동화할 수 있는가"를 API 가용성 표로 먼저 그렸다. 국내 주력 채널 두 곳의 쓰기 API가 이미 닫혀 있다는 사실이 설계를 정했다 — 완전 자동 발행이 아니라 보조 발행, 그리고 그 대신 발행 전 단계(팩트·검토·게이트)를 철저히 자동화하는 쪽으로. 막힌 곳을 우회하려 하지 않고, 자동화할 수 있는 곳에 자동화를 몰아넣은 게 결과적으로 정책 리스크도 줄였다.