finance-agent
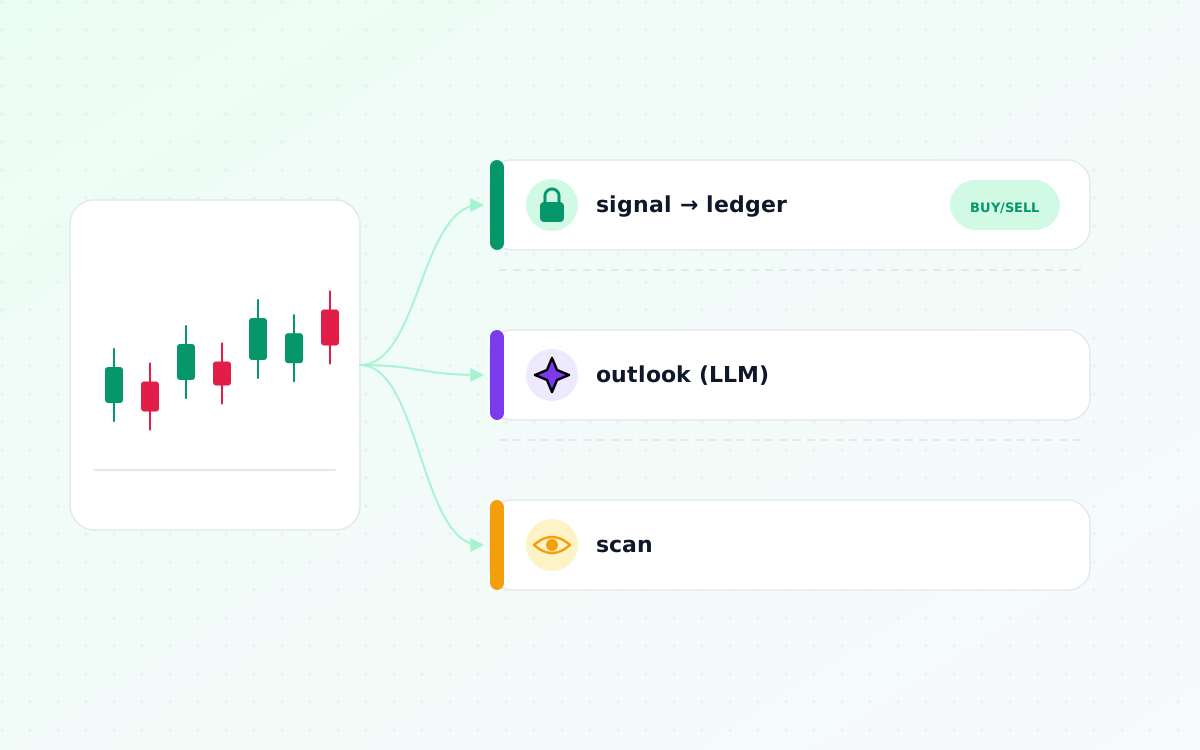
내부 시스템결정론 시그널·LLM 전망·밈 주식 스캔 — 섞이면 안 되는 세 기능을 끝까지 갈라 둔 투자 분석 도구
- 기간
- 2026-07 ~ 현재
- 커밋
- 38
- 독립 기능
- 3개
- 스캔 대상
- 상장 약 4천 종목
- 테스트
- 19개
기술 스택
- FastAPI
- LangGraph
- Next.js
- Pydantic
- React
- TypeScript
개요
무엇이고 누구를 위한 것인가국내 주식을 분석하는 개인용 도구다. 세 가지 독립된 기능으로 이뤄져 있다.
- 시그널 파이프라인 — 규칙 기반으로 매수·매도·보유 신호를 내고 원장에 쌓는다(자동매매용 트랙레코드).
- 전망(outlook) — LLM이 기업 정보와 거시 정보를 종합해 서술형 전망을 낸다. 웹으로 공개하는 건 이 기능뿐이다.
- 밈 주식 스캔 — 거래량·뉴스·종목토론방 글이 급증한 종목을 찾아 보여준다.
LangGraph로 에이전트 오케스트레이션을 익히는 것과 실제 쓰는 도구를 만드는 것을 한 프로젝트에서 같이 진행했다.
문제
무엇이 문제였나투자 판단은 근거를 남기지 않으면 배울 수 없다. 시간이 지나 결과만 보면 무엇이 맞았고 무엇이 운이었는지 구분할 수 없다. 트랙레코드는 기록을 시작한 날부터만 쌓인다.
여기에 LLM을 붙이면 어려워진다. LLM의 출력은 확률적이다. 같은 입력에 다른 답을 내는 판단이 원장에 섞이면, 나중에 백테스트를 돌려도 결과가 재현되지 않는다. 또 LLM은 "오를 것이다" 같은 확정적 예측을 그럴듯하게 만들어 낸다.
그리고 학습용 예제는 동작을 확인하고 나면 버려진다. LangGraph를 깊이 익히려면 매일 실제로 쓰는 대상이 필요했다.
접근
어떻게 풀었나- 세 기능을 섞지 않는다. 시그널·전망·스캔은 각자 별도 명령이고 서로를 건드리지 않는다. 특히 확률적 산출물인 전망은 시그널 원장에 절대 기록하지 않는다 — 백테스트의 결정성을 지키기 위해서다. 스캔도 판단이 아니라 스크리닝이라 원장에 남기지 않는다.
- 판정은 결정론, 서술만 LLM. 시그널 파이프라인에서 매수·매도·보유 판정은 규칙이 하고, LLM은 그 근거를 글로 쓰는 한 곳에서만 쓴다. 분석 노드들은 판정에 관여하지 않는 결정론 노드로 남겨 LLM을 두 번 부르지 않는다.
- 방향성 있는 신호만 사람이 승인한다. 보유(HOLD)는 자동 승인, 매수·매도는 LangGraph
interrupt()로 사람 승인을 받는다. 무인 실행(cron) 중엔 승인 대기를 건너뛰고, 나중에 사람이 다시 실행하면 그 지점에서 재개한다.
주요 기능
사용자가 실제로 쓰는 것- 시그널 파이프라인 — 수집 → 기술적·재무·뉴스 분석(병렬) → 신호 → 근거 서술(LLM) → 승인 → 원장 기록
- 전망 — 기업 정보(추세·재무·뉴스)에 거시 정보(환율·국제정세·전쟁·부동산 경기)를 더한 서술형 전망, 매일 리포트
- 밈 주식 스캔 — 거래량 급증(자체 20일 평균 대비) + 뉴스 언급량 + 종목토론방 글량, 상장 전체 약 4천 종목 "발견" 모드
- 웹 — 전망·리포트 화면(Next.js), 로그인
아키텍처
어떻게 구성돼 있나 시그널 파이프라인 (main.py, LangGraph)
collect 결정론 — 시세·재무·뉴스 수집
▼
analyze_* × 3 병렬 서브그래프 — 기술적(이동평균 교차)·재무(DART)·뉴스
▼ 재무·뉴스는 판정에 관여하지 않고 근거 자료로만 쓴다
signal 결정론 — 매수·매도·보유 판정
▼
rationale LLM — 근거 서술 (LLM은 여기서만)
▼
approve interrupt — BUY/SELL만 사람 승인, HOLD는 자동
▼
record 결정론 — 원장 기록
전망 (outlook.py) — 위 collect·analyze_* 재사용 + 거시 컨텍스트(한 번 수집, 전 종목 공유)
→ LLM 서술 (조건부 표현만, 마지막 문장 "매매 신호가 아님")
스캔 (scan.py) — volume_ratio 1차 필터 → 뉴스·게시글 건수 + 자체 축적 baseline 배수
시세: KIS(계좌 필요) 또는 pykrx(KRX 공개 데이터, 계좌 불필요)
재무: DART
웹: Next.js(Vercel) ── FastAPI(Render) ── Neon Postgres
LLM: 사내 LiteLLM 게이트웨이기술적 의사결정
무엇을 고르고 무엇을 버렸나- 거시 뉴스 검색을 실측해 고쳤다. "전쟁" 같은 넓은 단어로 검색하면 "가격 전쟁" 같은 은유가 섞여, 관련 있는 기사가 20건 중 1건뿐이었다. "우크라이나 전쟁"·"중동 전쟁"처럼 하위 쿼리로 쪼개고 키워드 포함 여부로 걸러 10건 중 4~5건으로 올렸다. 환율·부동산 전용 API를 붙이는 대신 검색어를 다듬는 쪽을 먼저 택했고, 구조화된 수치가 필요해지면 그때 전용 소스(예: 한국은행 ECOS)로 바꾼다.
- LLM이 없으면 전망이라고 부르지 않는다. LLM이 설정되지 않은 환경에서는 "전망"이 아니라 원시 정보만 나열한다고 명시하고 보여준다. 없는 판단을 지어내지 않는다.
- 스캔의 판정 기준은 이미 정규화된 신호 하나로. 거래량은 종목 자체의 20일 평균 대비라 처음부터 정규화돼 있어 1차 필터로 쓴다. 뉴스·게시글 건수는 종목마다 기준이 달라 판정에 쓰지 않고, 스캔할 때마다 스스로 기준선을 쌓아 배수로만 보여준다. 한 번이라도 눈에 띈 종목만 추적한다.
- 비공식 수집은 기본으로 꺼 둔다. 종목토론방은 공식 API가 없어 공개 페이지를 읽는다. 다른 소스처럼 "키가 있으면 자동으로 켜짐"이 아니라 명시적으로 켜야만 동작하게 했고, 개인 저빈도 조회 용도로만 쓴다.
- 화면을 갈아엎되 계정은 옮기지 않았다. Streamlit은 라우팅·딥링크·모바일 대응에 한계가 있어 같은 백엔드 로직을 FastAPI로 감싸고 화면을 Next.js로 새로 짰다. 기존 인증 라이브러리의 비밀번호 해시와 새 API의 해시가 둘 다 표준 bcrypt임을 직접 교차 검증해, 기존 계정이 비밀번호 그대로 로그인되게 했다. 병행 운영 후 Streamlit 서비스와 전용 DB는 완전히 정리했다.
결과
무엇이 달라졌나개인용 도구로 운영 중이며, 전망·리포트만 웹으로 공개한다.
- 세 기능이 같은 수집·분석 노드를 재사용하면서도 원장은 결정론 시그널만 갖는다.
- 시장 전체 약 4천 종목을 훑는 스캔 모드로 티커를 몰라도 후보를 찾는다.
- 거시 뉴스의 관련도를 실측 기준 1/20에서 4~5/10으로 올렸다.
- 테스트 19개, 커밋 38개.
배운 점
다시 한다면LLM을 쓰는 시스템에서 가장 지키기 어려운 건 재현성이었다. 판정·서술·발견을 한 파이프라인에 넣으면 편하지만, 그 순간 원장이 확률적 출력으로 오염되고 백테스트가 의미를 잃는다. 기능을 셋으로 쪼개고 "무엇이 원장에 들어갈 수 있는가"를 먼저 정한 게 이 프로젝트의 뼈대가 됐다. 검색 정확도도 마찬가지였다 — 감으로 쿼리를 고치지 않고 통과율을 세어 가며 고쳤다.