QA Agent
내부 시스템기획서와 Figma 시안에서 검수항목을 만들고, 사람이 승인한 것만 자동 검수 — 환각은 4겹 게이트로
- 기간
- 2026-08 ~ 현재
- 커밋
- 49
- 백엔드 테스트
- 641개
- 실전 파일럿
- 6회
- 검증 게이트
- 4계층
기술 스택
- Cloudflare Containers
- Cloudflare Workers
- FastAPI
- Playwright
- Pydantic
- Python
- React
- TypeScript
- httpx
개요
무엇이고 누구를 위한 것인가기획서(스토리보드)와 Figma 디자인 시안을 넣으면 검수항목을 자동으로 생성하고, 사람이 승인한 항목만 실제 사이트에서 자동으로 검수하는 QA 파이프라인이다(Spec-to-Test + Agentic QA). 실행 결과는 트리아지와 품질 리포트로 이어지고, 리포트가 출시 확대 여부를 판정한다.
문제
무엇이 문제였나QA 검수항목은 기획서와 디자인 시안을 사람이 읽어 손으로 만든다. 여기에 두 가지 비용이 붙는다.
동기화가 밀린다. 기획서가 바뀌면 검수항목도 바뀌어야 하는데, 문서 개정과 항목 갱신 사이에 늘 시차가 생긴다. 낡은 항목으로 검수하면 통과해도 의미가 없다.
실행이 반복 수작업이다. 만든 항목을 실제 사이트에서 하나씩 확인하는 일이 릴리스마다 되풀이된다.
이걸 LLM으로 자동화하면 새 문제가 생긴다. 보고된 LLM 환각률은 15~52%다. 기획서에 없는 요구사항을 지어낸 검수항목이 자동으로 실행되면, QA를 안 하느니만 못한 결과가 나온다.
접근
어떻게 풀었나- 모든 입력을 Gherkin으로 바꾼다. 기획서·시안 어디서 왔든 Given-When-Then을 중간 표현으로 삼고, 그것을 Playwright 액션으로 변환한다. 입력이 늘어도 실행기는 하나다.
- 환각을 4겹으로 거른다. 생성 단계에 검증 게이트를 4계층으로 두고, 실행 전에 한 번 더 확인한다.
- AI가 만들고, 사람이 승인하고, 승인된 것만 실행한다. 자동화의 안전장치는 승인 게이트다. 파이프라인 전체를 열어 두지 않는다.
- 도메인 모델이 출처 없는 항목을 거부한다. 모든 검수항목은 출처(
SourceRef)를 하나 이상 가져야 하고, 없으면 객체 생성 시점에 거부된다. 프롬프트로 부탁하는 게 아니라 타입으로 강제한다.
주요 기능
사용자가 실제로 쓰는 것- 입력 파싱 — 기획서(PDF·DOCX·MD), Figma REST API(파일·이미지)
- 검수항목 자동 생성 — 우선순위 태깅, ISTQB 테스트 설계 기법, HTSM 휴리스틱 관점, 예외 케이스 포함 원칙
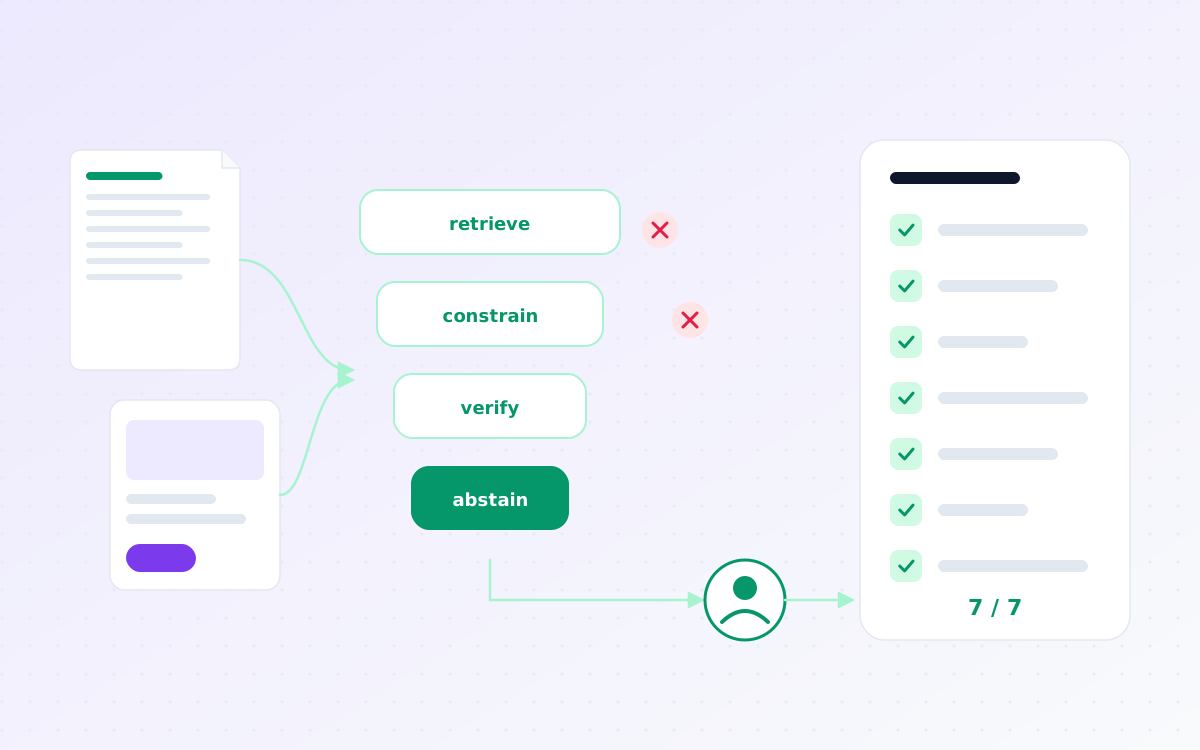
- 4계층 검증 게이트 — 근거 주입·스키마 강제·충실도 검증·불확실 시 보류
- 승인 워크플로 — 승인·재승인 경로, 개인정보 마스킹과 실행 시 복원
- 자동 검수 실행 — Playwright 실행기, 실행 전 셀렉터 존재 확인(dry run), 스크린샷·트레이스 증거 수집
- 트리아지·품질 리포트 — 실패를 결함·오탐·실행 오류로 분류, 오탐률·출시 준비도 산출, sign-off 게이트
- 화면 문자열 카탈로그 — 실제 화면의 문자열을 미리 대조해 셀렉터 오류를 줄임
아키텍처
어떻게 구성돼 있나 StoryboardParser ◀── 기획서 (PDF·DOCX·MD)
FigmaRepository ◀── Figma REST (/v1/files, /v1/images)
│
▼
GenerateInspectionItems (유스케이스)
입력 정규화 → LLM 구조화 → Gherkin(Given-When-Then)
├─ ① Retrieve 기획서·시안 텍스트를 근거로 주입 — 추측 금지
├─ ② Constrain Pydantic 스키마로 허용된 검증 타입만 생성
├─ ③ Verify 두 번째 LLM 호출로 "기획서에 근거 있는가" 충실도 채점
└─ ④ Abstain 다수 샘플의 의미 일치도가 낮으면 사람에게 넘김
▼
사람 승인 ──▶ RunAutoInspection (오케스트레이터)
Playwright dry run(셀렉터 확인) → 실행 → 증거 수집
→ 트리아지 → 품질 리포트 → sign-off 게이트
Clean Architecture: 도메인 ← 유스케이스 ← 어댑터(LLM·Figma·Playwright)
배포: Cloudflare Workers + Containers, 문서 D1·R2기술적 의사결정
무엇을 고르고 무엇을 버렸나- 환각 통제를 "부탁"이 아니라 "구조"로. 프롬프트에 "지어내지 마"라고 쓰는 것으로는 15~52%를 막을 수 없다. 근거 주입(Retrieve)으로 추측할 이유를 없애고, 스키마(Constrain)로 형식을 묶고, 별도 호출(Verify)로 근거 여부를 채점하고, 확신이 낮으면 아예 답하지 않게(Abstain) 했다. 실행 직전에는 Playwright가 셀렉터가 실제로 존재하는지 확인한다.
- 멀티 에이전트를 역할로 나눴다. 의사결정(LLM)·상태 변경(Playwright 실행)·데이터 제공(증거 수집)·정보 입도 조절(트리아지)·순서 관리(오케스트레이터) 다섯 역할로 나눈 구조를 차용했다. 지금은 한 프로세스 안에서 돌지만, 역할이 분리돼 있어 서브에이전트로 떼어낼 수 있다.
- 반응형·상태별 UI 차이는 예외 규칙으로. 디자인 시안과 실제 화면을 비교할 때 반응형 레이아웃이나 상태별 UI 차이가 오탐이 된다. 허용 오차를 예외 규칙으로 정의해 거른다.
- 개인정보는 마스킹해서 LLM에 보내고 실행 때 복원한다. 기획서의 개인정보 형태 값은 생성 단계에서 가리고, 검수 실행 시 원래 값으로 되돌린다.
- 긴 생성은 스트리밍으로. 프록시의 비스트리밍 응답 상한(120초)에 걸려 생성이 잘리는 것을 SSE 스트리밍으로 피했다.
결과
무엇이 달라졌나내부 시스템으로 운영 중이며 공개 도메인은 없다. 기획서·시안 입력부터 승인, 자동 검수, 트리아지, 품질 리포트까지 한 파이프라인으로 이어진다.
실전 파일럿을 6회 돌리며 결함을 잡았다.
- 1차 — 생성부터 품질 리포트까지 전 사이클을 처음 돌렸다. 8개 항목이 생성되고 전부 승인됐지만, 오탐률 28.6%에 출시 준비도 0.0이 나와 sign-off 게이트가 "확대 불가"로 정상 작동했다. 생성 파이프라인 결함 4건을 찾았다.
- 2차 — 실행기의 문법·타이밍 결함 6건을 고쳐 실행 오류 0을 달성했다.
- 3차 — 재승인 경로, 개인정보 복원, 어설션 진단을 보강해 전 항목 통과.
- 4차 — 실제 화면 문자열을 실행 전에 대조하는 검토를 추가해 첫 실행 7/7 통과, 재실행 0, 환각 0.
- 5·6차 — "P0 통과 확인" 분류값이 없어 오탐률이 왜곡되던 문제를 고치고, 화면 문자열 카탈로그를 화면 간 이동과 늦게 렌더되는 요소까지 확장했다.
백엔드 테스트 641개.
배운 점
다시 한다면첫 파일럿에서 Verify 게이트가 모든 항목에 0점을 줬다. 게이트가 엄격해서가 아니었다 — 시스템 프롬프트의 {{SPEC}} 자리표시자가 치환되지 않은 채 그대로 모델에 들어갔고, 응답의 점수 키 이름도 파서가 기대한 것과 달랐다. 검증 장치가 고장나면 "전부 통과"가 아니라 "전부 실패"로 나타나 오히려 다행이었지만, 검증 장치 자체도 검증해야 한다는 걸 배웠다. 파일럿은 사이클마다 다른 층의 결함을 드러냈다 — 생성, 실행기, 승인 흐름, 화면 문자열 순으로. 한 번에 전부 맞추려 하지 않고 사이클마다 한 층씩 고친 게 6회 만에 7/7을 만든 방식이었다.