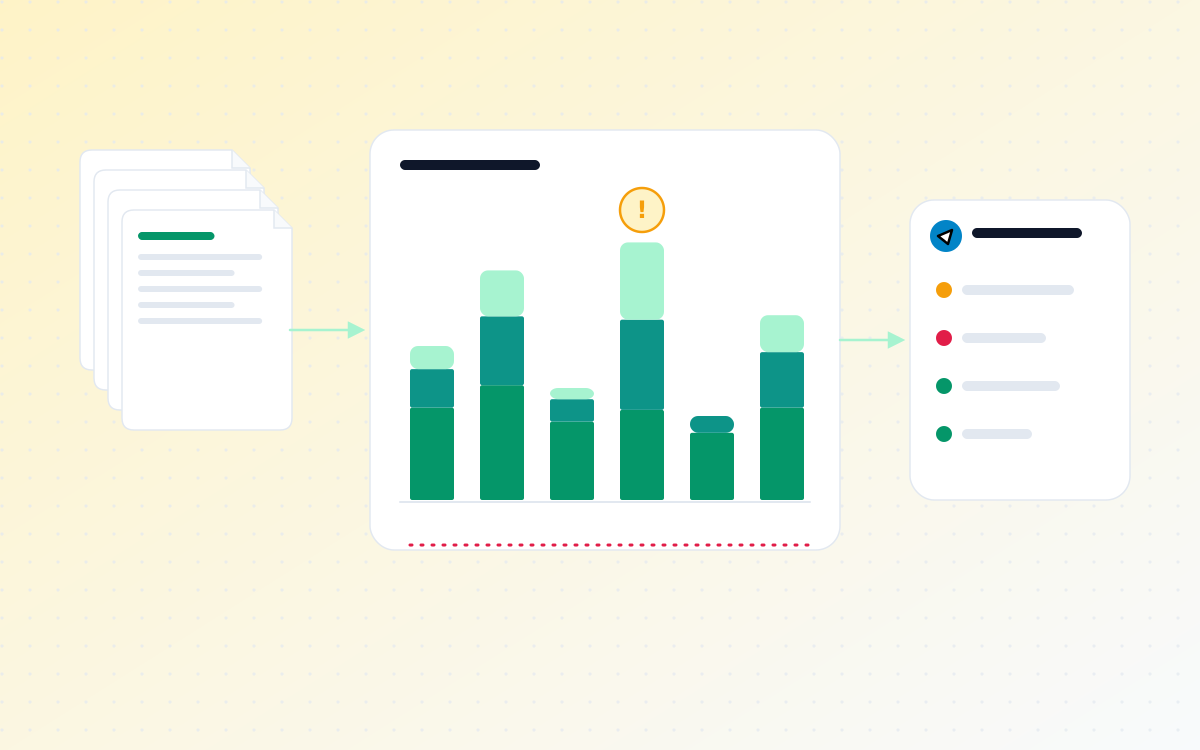
비용 추적 대시보드
내부 시스템태깅 없는 청구를 프로젝트 단위로 귀속시키고, 통계 대신 규칙으로 비용 누수를 잡는다
- 기간
- 2026-08 ~ 현재
- 커밋
- 74
- 수집 공급사
- 7곳
- 수집 주기
- 일 1회
- 월 비용 규모
- 약 $15
기술 스택
- Cloudflare Workers
- Next.js
- OpenNext
- React
- Sentry
- Tailwind CSS
- TypeScript
개요
무엇이고 누구를 위한 것인가Cloudflare·OpenAI·Anthropic·GCP·OpenRouter·GitHub·NVIDIA, 7곳의 클라우드·AI 비용을 매일 모아 내부 프로젝트 단위로 귀속시키는 대시보드다. 무료 한도를 얼마나 쓰고 있는지, 어디서 돈이 새고 있는지를 매일 아침 요약해 텔레그램으로 보낸다.
Cloudflare Access로 보호된 내부 도구다.
문제
무엇이 문제였나청구서는 공급사 단위로 오는데, 알고 싶은 건 프로젝트 단위 비용이다. Cloudflare는 대부분 SKU에 리소스 태깅이 없어서 어느 워커·버킷·D1이 어느 프로젝트 것인지 청구 데이터만으로는 알 수 없다. 삭제된 워커는 사용량 API에서 이름조차 __unknown__으로 온다. 공급사를 여러 개 쓰면 이 문제가 공급사 수만큼 반복되고, 각자 API 모양이 다르며, NVIDIA NIM처럼 비용 API 자체가 없는 곳도 있다.
더 어려운 건 누수다. 이 계정의 월 비용은 약 15달러다. 이 규모에서 누수는 "갑자기 튀는 숫자"로 나타나지 않는다. 잠들어야 할 컨테이너가 하루 종일 깨어 있거나, 캐시가 일정한 속도로 계속 자라거나, 수집기가 매일 빈 값을 보고하는 식이다. 틀린 상태가 처음부터 기준선이면 이상탐지는 아무것도 찾지 못한다.
접근
어떻게 풀었나- 매핑은 명시적으로, 누락은 드러나게.
service:resource_name → 프로젝트매핑을 설정 파일로 수동 관리한다. 추측하지 않고, 매핑되지 않은 리소스는unmapped로 떨어뜨려 누락이 보이게 했다. 조용히 0원으로 처리하지 않는다. - 단가표를 최소화했다. 실제 청구 금액을 직접 주는 공급사(OpenAI·Anthropic·GCP·OpenRouter·GitHub)는 단가표가 필요 없다. 정적 단가표는 그게 불가능한 Cloudflare 하나만 유지한다.
- 비용 API가 없는 구간은 로그로 메웠다. NVIDIA NIM은 사내 AI Gateway의 프록시 지출 로그에서 해당 요청만 걸러 사용량을 기록한다.
- 누수는 통계가 아니라 "원래 해야 할 일"로 검사한다. 규칙마다 리소스가 원래 어떻게 동작해야 하는지를 적고, 그것을 확인한다. 학습할 과거 데이터가 필요 없다.
주요 기능
사용자가 실제로 쓰는 것- 프로젝트별 비용 — 공급사·서비스·리소스를 프로젝트 라벨로 귀속, 기간 선택
- 무료 한도 추적 — 공급사별 무료 한도 대비 사용량. 초과는 비율이 아니라 금액 순으로 정렬
- 저장 용량 추세 — 저장 한도는 누적 합이 아니라 최신 스냅샷 기준, 소진 시점을 추세로 예측
- 일일 누수 점검 — 상시 깨어 있는 컨테이너, 일정하게 자라는 저장소, 빈 값만 보고하는 수집기
- 고아 리소스 검사 — 어느 프로젝트에도 매핑되지 않은 워커·리소스
- 유휴 vs 고장 구분 — 사용량이 0인 공급사가 정말 안 쓴 것인지, 수집기가 죽은 것인지 구분
- 텔레그램 다이제스트 — 매일 상태 요약
아키텍처
어떻게 구성돼 있나 GitHub Actions — 매일 cron
collect-cloudflare (GraphQL 사용량 + 정적 단가표)
collect-openai · anthropic · gcp(BigQuery export) · openrouter · github (실청구 USD)
collect-nvidia (AI Gateway 프록시 지출 로그 → 토큰만, 비용 $0)
│ 정규화
Cloudflare D1 — cost_records 한 테이블 + raw_json 원본 보존
│ 유니크 인덱스 (provider, service, resource, 기간) — 재실행해도 중복 적재 없음
│
leak-check ── 규칙 기반 점검 → 텔레그램 다이제스트
│
Next.js (OpenNext) ── Cloudflare Workers ── cost.azclab.com (Cloudflare Access)기술적 의사결정
무엇을 고르고 무엇을 버렸나- 상용 이상탐지를 시뮬레이션해 보고 버렸다. Vantage가 공개한 이상탐지 필터를 이 계정의 34일 데이터에 돌려 봤다. 손으로 찾은 실제 누수 7건 중 1건만 잡았고 정밀도는 33%였다 — 알림이 고장났다고 보는 50% 선 아래다. 이유는 일곱 중 여섯이 편차가 아니었기 때문이다. 24시간 고정된 컨테이너, 일정한 속도로 자라는 캐시, 매일 NULL을 보고하는 수집기 — 튀는 지점이 없으니 탐지할 것도 없었다. 그래서 통계 대신 규칙을 택했다.
- 알림은 사건이 아니라 상태를 보고한다. 다이제스트는 "오늘 무슨 일이 일어났나"가 아니라 "지금 무엇이 잘못돼 있나"를 보낸다. 알림 이력도, 재알림 억제도 필요 없다 — 내일도 사실인 문제는 다시 나오고, 고쳐진 문제는 사라진다.
- 임계값을 계정 규모에 맞게 300분의 1로 줄였다. 상용 도구의 가장 낮은 자동 임계값($5)도 이 계정에선 한 달 치의 3분의 1이다. 이 규모에선 금액 하한을 1차 관문, 비율을 확인으로 쓴다 — 엔터프라이즈 기본값과 반대다. 0.02달러짜리 테스트 호출이 0.06달러가 되면 비율로는 +200%이기 때문이다.
- 상시 가동 컨테이너는 하루가 아니라 일주일로 판정한다. 처음엔 하루 중 90% 이상 깨어 있으면 경고했는데, 매일 66~80%씩 깨어 있던 컨테이너를 놓쳤다. 약 3분마다 오는 폴링이 10분 수면 타이머를 계속 초기화하는데, 그 사이사이에 잠깐씩 잠들어 하루 90%에는 못 미쳤던 것이다. 정상적인 scale-to-zero 컨테이너는 15% 미만이라 일주일 비율로 바꿨다.
- 기준일은 "어제"가 아니라 "데이터가 있는 마지막 날". 수집기가 어제 데이터를 쓰기 전에 점검이 돌면, 빈 날을 전체 지출 붕괴로 읽고 모든 공급사에 경고를 낸다.
- 저장 한도의 경고 시점을 "이번 분기의 문제"로 잡았다. 너무 이르면 다이제스트에 영구히 남는 줄이 되고, 너무 늦으면 수명주기 규칙 하나로 끝날 일이 긴급 상황이 된다.
결과
무엇이 달라졌나cost.azclab.com에서 Cloudflare Access로 보호된 내부 대시보드로 운영 중이다.
- 7개 공급사의 비용·사용량을 매일 프로젝트 라벨로 귀속시킨다. 같은 구간을 다시 수집해도 숫자가 부풀지 않는다.
- 상시 깨어 있는 컨테이너·일정하게 자라는 저장소·빈 값만 보고하는 수집기를 매일 점검해 텔레그램으로 보고한다.
- 매핑 누락은
unmapped, 프로젝트 없는 리소스는 고아 리소스로 드러난다.
배운 점
다시 한다면이상탐지는 "평소와 다른 것"을 찾는다. 그런데 작은 계정의 누수는 대개 처음부터 잘못 설정된 채 평소가 된 것이다. 상용 필터를 자기 데이터로 시뮬레이션해 보기 전까지는 그 차이를 몰랐다. 규칙으로 바꾸면서 각 리소스가 "원래 무엇을 해야 하는가"를 적어야 했고, 그게 곧 운영 문서가 됐다. 임계값도 같은 교훈이었다 — 남의 기본값은 남의 규모에 맞춰져 있다.