infra-agent
베타SDK 한 줄로 붙는 MVP 통합 모니터링 — 에러를 LLM이 분석해 수정 PR까지
- 기간
- 2026-08 ~ 2026-08
- 커밋
- 12
- SDK
- Python·JS
- 컨테이너 비용
- 월 $7 → $2
기술 스택
- Alembic
- Cloudflare Containers
- Cloudflare Workers
- FastAPI
- Next.js
- Pydantic
- Python
- React
- SQLAlchemy
- Tailwind CSS
- TypeScript
- httpx
개요
무엇이고 누구를 위한 것인가여러 개의 웹 MVP 서비스를 한 곳에서 모니터링하는 시스템이다. 대상 서비스에 SDK를 한 줄 붙이면 헬스체크·메트릭·에러가 모이고, 새로운 에러가 나타나면 LLM이 원인을 분석해 수정 PR까지 만든다. 관리자는 승인만 한다.
2026년 8월에 만들어 운영하다가 현재는 대시보드가 내려가 있다. 그 사이 형제 프로젝트들은 기성 관측 서비스(Sentry + Grafana Cloud)로 옮겼다.
문제
무엇이 문제였나MVP를 여러 개 굴리면 각각에 모니터링을 붙이는 비용이 서비스 자체를 만드는 비용에 비해 과하게 느껴진다. 그래서 대개 안 붙이고, 죽은 걸 한참 뒤에 안다.
붙이더라도 서비스마다 계측 코드가 침투하면 MVP 코드가 모니터링 코드로 지저분해진다. 에러를 모아도 그다음 — 원인을 찾고 고치는 일 — 은 여전히 사람 몫이다.
접근
어떻게 풀었나- 계측을 한 줄로 낮췄다.
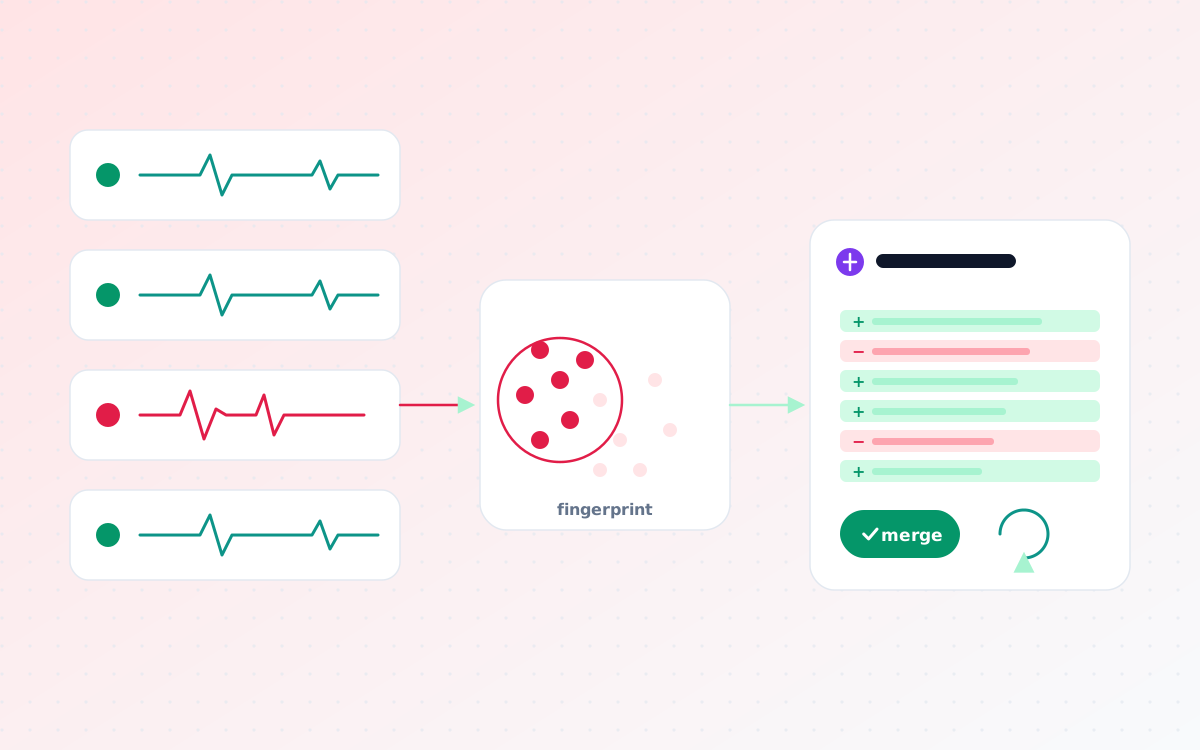
instrument(app)한 줄이면/metrics엔드포인트가 생기고 요청 메트릭이 모인다. 진입 장벽이 낮아야 실제로 붙인다. - 에러를 지문으로 묶는다. 예외를 자동 캡처해 지문(fingerprint)으로 묶어 배치 전송한다. 같은 에러가 천 번 나도 한 건으로 본다.
- 분석과 수정을 자동화하되 병합은 사람이. 새 지문이 나타나면 스케줄러가 LLM으로 원인과 수정안을 만들고, GitHub에 수정 PR을 연다. 관리자가 승인·거부·롤백한다.
주요 기능
사용자가 실제로 쓰는 것- Python SDK — FastAPI·Starlette 공용 ASGI 미들웨어,
/metrics(Prometheus 포맷), 의존성 헬스체크 통합, 예외 자동 캡처 - JS/TS SDK — Next.js App Router와 Cloudflare Workers 지원
- 헬스체크 폴링 — 등록된 서비스를 주기적으로 확인
- 에러 대시보드 — 지문별 집계, 추세 차트, 서비스별 필터
- 장애 알림 — 발생·복구를 Slack·Discord 웹훅으로
- LLM 자동 분석 — 신규 지문의 원인과 수정안
- 수정 워크플로 — 수정 PR 생성 → 승인·거부·롤백, 재발 시 승인된 패치를 자동 재적용
아키텍처
어떻게 구성돼 있나 대상 서비스들
Python: instrument(app) → /metrics + 예외 캡처
JS/TS: infra-agent-sdk → 예외 캡처 (Workers 플러시 대응)
│ 배치 전송 (/logs)
│ ▲ 헬스체크 폴링 (백엔드 → 서비스)
FastAPI 백엔드 ── Cloudflare Containers (lite 인스턴스)
├─ 수집·집계 (지문화)
├─ 스케줄러 ── 신규 지문 → LLM 분석 → 원인·수정안
├─ remediation ── GitHub 수정 PR → 승인 / 거부 / 롤백
│ 재발 → 승인된 패치 재적용 PR → CI 통과 시 자동 병합
└─ 웹훅 (Slack · Discord)
│ 컨테이너는 D1 직접 바인딩 불가 → Worker 내부 프록시(시크릿 헤더) 경유
Cloudflare D1
Next.js 대시보드 ── Cloudflare Workers (KV 엣지 캐시, SWR)기술적 의사결정
무엇을 고르고 무엇을 버렸나- DB를 옮기면서 호출 지점은 하나도 안 고쳤다. Neon 무료 전송량이 바닥나 Cloudflare D1로 옮겨야 했다. 라우터·서비스의 88개 DB 호출 지점을 고치는 대신, SQLAlchemy
Session과 호환되는 D1 어댑터를 만들었다. 조회는 SQLite 문법으로 컴파일하고, 쓰기는 flush 시점에 INSERT·UPDATE·DELETE로 변환한다. 컨테이너가 D1에 직접 붙을 수 없어 Worker를 내부 프록시로 뒀다. - 메트릭 레이블 폭증을 막았다. 실제 경로(
/items/123) 대신 라우트 패턴(/items/{id})을 레이블로 써서 카디널리티가 터지지 않게 했다. 메트릭 엔드포인트 자신은 집계에서 뺐다. - 오버헤드를 줄이려고 순수 ASGI로. Starlette의
BaseHTTPMiddleware대신 순수 ASGI 미들웨어로 구현했다. - 승인된 수정은 다시 쓴다. 이미 사람이 승인한 패치로 고친 에러가 재발하면, 같은 패치를 자동으로 다시 PR로 올리고 CI를 통과하면 병합한다. 사람의 판단을 한 번만 받는다.
- 비용을 실측해 줄였다. 컨테이너 인스턴스를 basic에서 lite로 내려 월 약 7달러를 2달러로 줄였다. 대시보드 조회는 KV 엣지 캐시로, 목록 화면의 N+1 쿼리는 GROUP BY 하나로 합쳤다.
결과
무엇이 달라졌나2026년 8월 한 달 동안 SDK 두 종, 에러 대시보드, LLM 분석·수정 워크플로까지 만들어 mrtg.azclab.com에서 운영했다.
- Python SDK가 형제 프로젝트(best-agent)에 실제로 붙어 운영됐다.
- DB 이전에서 88개 호출 지점을 무수정으로 옮겼다.
- 현재는 도메인 DNS가 없어 서비스가 내려가 있다. 커밋은 2026-08-29에서 멈췄다.
배운 점
다시 한다면직접 만든 모니터링을 붙였던 best-agent는 얼마 지나지 않아 SDK를 걷어내고 Sentry + Grafana Cloud로 옮겼다. 에러 지문화·추세·알림은 기성 서비스가 더 잘하고, 그걸 직접 유지하는 비용이 더 컸다. 이 프로젝트에서 기성 서비스가 못 하는 부분은 "분석 → 수정 PR → 승인 → 재발 시 재적용"으로 이어지는 수정 워크플로 쪽이었다. 다시 한다면 수집·대시보드는 기성 서비스에 맡기고, 그 위에 수정 워크플로만 얹었을 것이다.